
Un site marchand qui ralentit, ce n'est plus forcément un site mal construit. Depuis deux ans, une part croissante de la charge des serveurs ne vient plus des visiteurs ni même des moteurs de recherche, mais des robots d'entraînement des modèles d'intelligence artificielle. Sur une boutique que j'ai dépannée cet été, ce trafic représentait 68 % du total. Pas 68 % des robots : 68 % de tout ce que le serveur traitait.
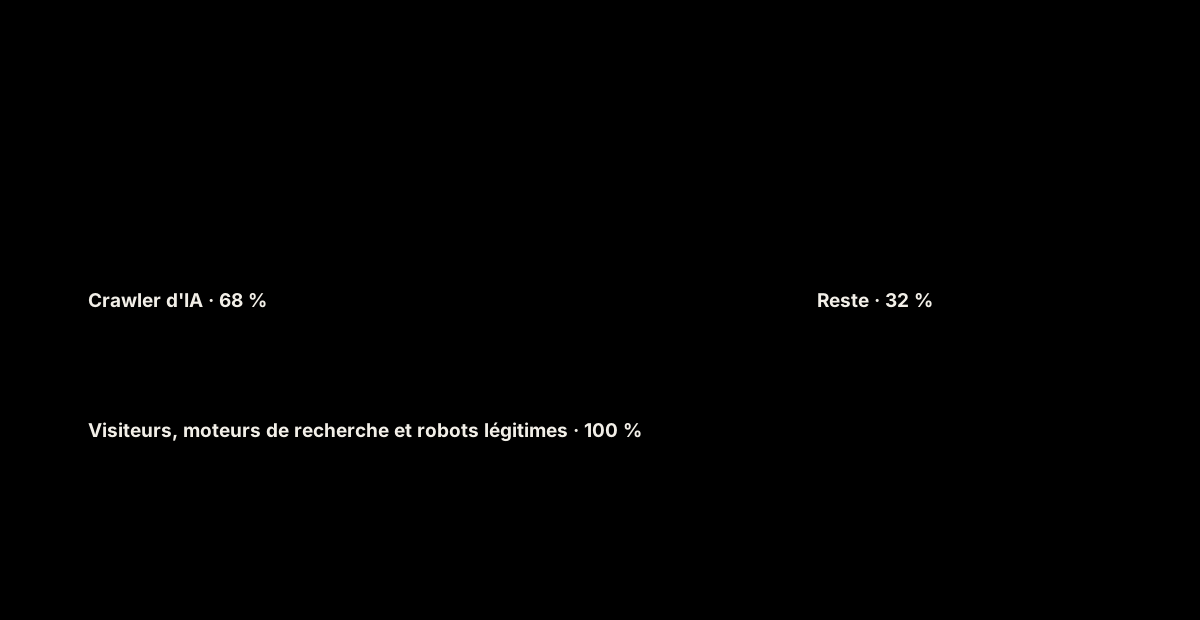
Relevé sur une boutique PrestaShop en juillet 2026. Les proportions sont issues des journaux d'accès ; le graphique ne représente que les deux états mesurés, avant et après blocage.
Un robot qui ne rapporte aucune visite
La différence avec un moteur de recherche est nette, et c'est elle qui change tout.
Googlebot explore un site pour l'indexer. L'exploration a un coût, mais elle a une contrepartie : des visiteurs. C'est un échange, et un commerçant a tout intérêt à le faciliter.
Un crawler d'entraînement, lui, aspire du contenu pour alimenter un modèle. Il ne renvoie personne. Il n'apparaît dans aucune statistique de fréquentation, ne génère aucune commande, et n'améliore aucun classement. Le serveur travaille, paie, et ne reçoit rien en retour.
Il faut distinguer ces robots d'entraînement des agents qui consultent une page à la demande d'un utilisateur — quand quelqu'un pose une question à un assistant et que celui-ci va lire votre fiche produit pour y répondre. Ceux-là amènent une visite, ou au moins une mention. Ils sont peu nombreux et se comportent normalement. Ce ne sont pas eux qui font tomber les serveurs.
Pourquoi le commerce en ligne est la cible
Un site vitrine compte trente pages. Un catalogue en compte cinq mille — et surtout, il expose une navigation à facettes : les filtres par taille, couleur, marque, prix, disponibilité.
Chaque combinaison de filtres produit une URL. Quinze filtres se combinent en dizaines de milliers d'adresses distinctes, toutes valides, toutes uniques aux yeux d'un robot. C'est un espace quasi infini à explorer.
Et ces pages-là sont précisément les plus chères à produire : ce sont celles qui déclenchent les requêtes SQL les plus lourdes. Sur la boutique en question, 99,7 % des requêtes du crawler visaient les pages à facettes. L'asymétrie est brutale : une requête coûte quelques millisecondes au robot et plusieurs centaines au serveur.
Le résultat se lit dans les journaux sous forme d'erreurs 503 Service Unavailable — le serveur qui refuse de répondre parce qu'il n'a plus de
processus disponible. Pour un client, c'est simplement une boutique qui ne
s'ouvre pas.
Le diagnostic ne se voit pas depuis le tableau de bord
C'est le point qui égare le plus souvent. L'hébergeur regarde ses métriques et conclut que la machine se porte bien. Il a raison : le processeur, la mémoire et les disques sont en bon état. Le serveur n'est pas défaillant, il est occupé.
Aucun tableau de bord d'hébergement ne fait la différence entre une requête légitime et une requête parasite. Seuls les journaux d'accès bruts le montrent — qui demande quoi, à quelle cadence, avec quelle signature. C'est fastidieux, et c'est le seul endroit où la réponse se trouve.
Les bloquer ne coûte rien au référencement
C'est la question que pose tout commerçant, et la réponse est rassurante.
Les crawlers d'entraînement utilisent des identifiants distincts de ceux des moteurs de recherche. Bloquer les premiers ne touche ni Google, ni Bing, ni les robots qui fabriquent les aperçus de liens sur les réseaux sociaux. Ces agents-là se préservent explicitement, et il faut le faire : ce sont eux qui apportent les visites.
Reste à savoir comment bloquer. Trois niveaux, du plus poli au plus ferme :
Le fichier robots.txt est une consigne, pas une barrière. Les acteurs
sérieux la respectent ; les autres l'ignorent. Il faut l'écrire — c'est la
première chose à vérifier, beaucoup de boutiques n'en ont tout simplement pas —
mais il ne suffit jamais seul.
Le blocage au niveau serveur répond en 403 avant d'exécuter la moindre ligne de PHP et sans toucher à la base de données. C'est ce qui soulage réellement la machine : le coût d'un refus est mille fois inférieur à celui d'une page produite.
Le filtrage en amont, par un CDN, arrête le trafic avant qu'il n'atteigne le serveur. Indispensable dès que le volume dépasse ce qu'une machine peut absorber — à condition d'en verrouiller l'accès direct, faute de quoi la protection se contourne.
Ce qu'il faut surveiller
Trois signaux méritent qu'on ouvre les journaux : des lenteurs sans rapport avec la fréquentation réelle, des erreurs 503 par périodes, et une charge serveur qui ne retombe pas la nuit. Le dernier est le plus parlant : vos clients dorment, pas les robots.
Ce type de panne se diagnostique par les journaux, pas par supposition. La cause réelle est souvent très éloignée de celle que l'on soupçonne — et parfois, comme je l'ai raconté dans le cas de Sellerie GZ, il y en a plusieurs, qui se succèdent en se masquant les unes les autres.